

Im ersten Teil wurde am Beispiel von KAFFEEPAUSE gezeigt, wie der Huffman-Algorithmus anhand von Zeichenhäufigkeiten einen Binärbaum erstellt und daraus platzsparende, eindeutige Codes gewinnt. Die Grundlagen werden in Teil 1 auf ffritze.de ausführlich erklärt.
In diesem zweiten Teil wird der Huffman-Algorithmus in Python implementiert und in einem Jupyter Notebook schrittweise nachvollzogen. Dabei steht nicht nur das fertige Programm im Mittelpunkt. Die einzelnen Datenstrukturen und Verarbeitungsschritte werden sichtbar gemacht, sodass der Aufbau des Huffman-Baums und die Erzeugung der Codes direkt ausprobiert werden können.
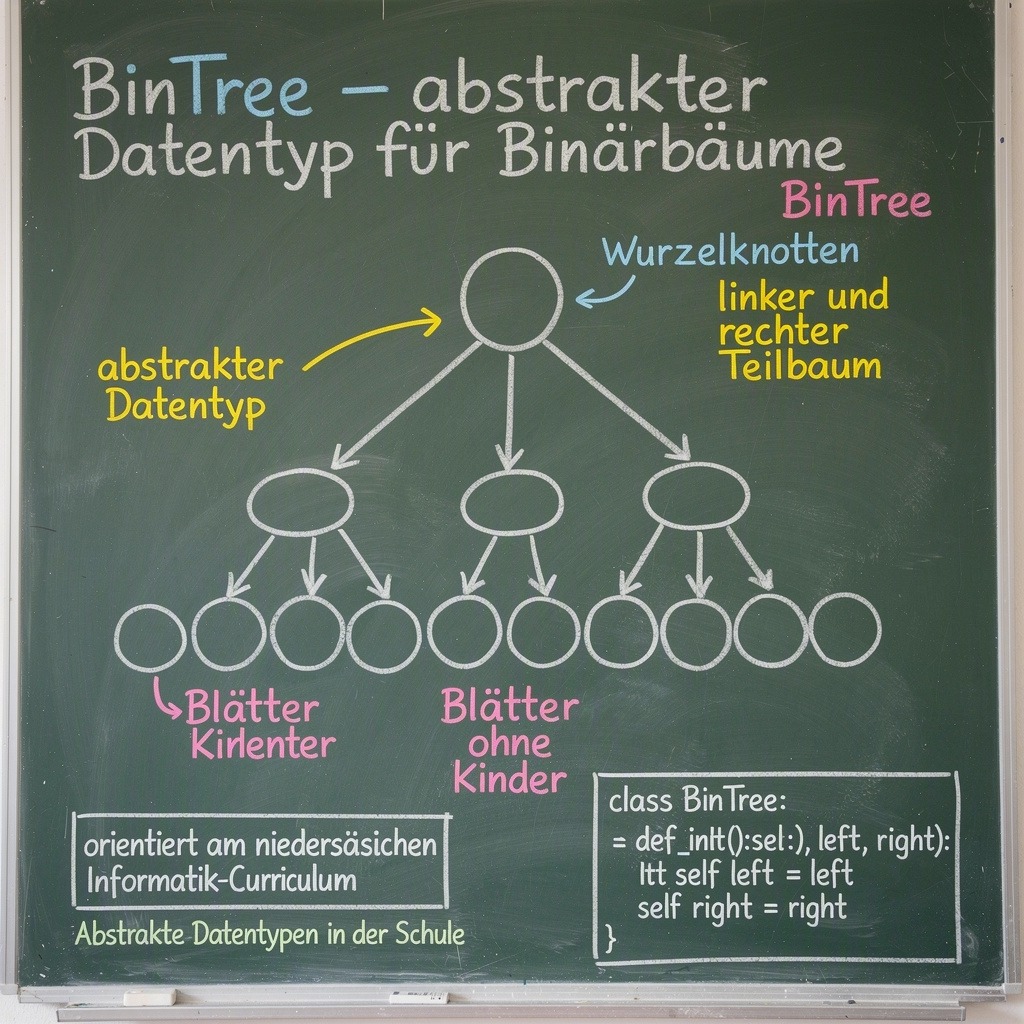
Für die Darstellung des Baums wird der abstrakte Datentyp BinTree verwendet. Dieser orientiert sich an den abstrakten Datentypen, die im niedersächsischen Informatik-Curriculum eine Rolle spielen. Die dazugehörigen Python-Implementierungen und weitere Informationen zu abstrakten Datentypen, darunter auch zum Binärbaum, sind hier beschrieben: Abstrakte Datentypen in der Schule: Python-Implementierungen zum Download.
Das Notebook verbindet damit die theoretischen Grundlagen aus Teil 1 mit einer konkreten Programmierung. Ausgehend von einem Text wird zunächst eine Häufigkeitsanalyse durchgeführt. Auf dieser Grundlage entsteht ein Huffman-Baum, an dem die Codierung des Textes anschließend erprobt wird.
Jupyter Notebook öffnen
Das vollständige Notebook kann direkt in JupyterLite geöffnet und dort ausgeführt werden. Die Datei enthält neben der Häufigkeitsanalyse und der Erstellung des Huffman-Baums auch weitere Funktionen zur Erzeugung der Huffman-Codes sowie zur Codierung und Decodierung von Texten. Öffne das Notebook und spiele den gesamten Ablauf einmal am Wort „KAFFEEPAUSE“ durch:
Huffman-Algorithmus in JupyterLite öffnen
Setze den Code nach dem Öffnen oben rechts zunächst auf „Trusted“und wähle anschließend als Kernel Python aus. Jede Codezellen kann nacheinander mit Shift + Enter ausgeführt werden.
Häufigkeiten der Zeichen bestimmen
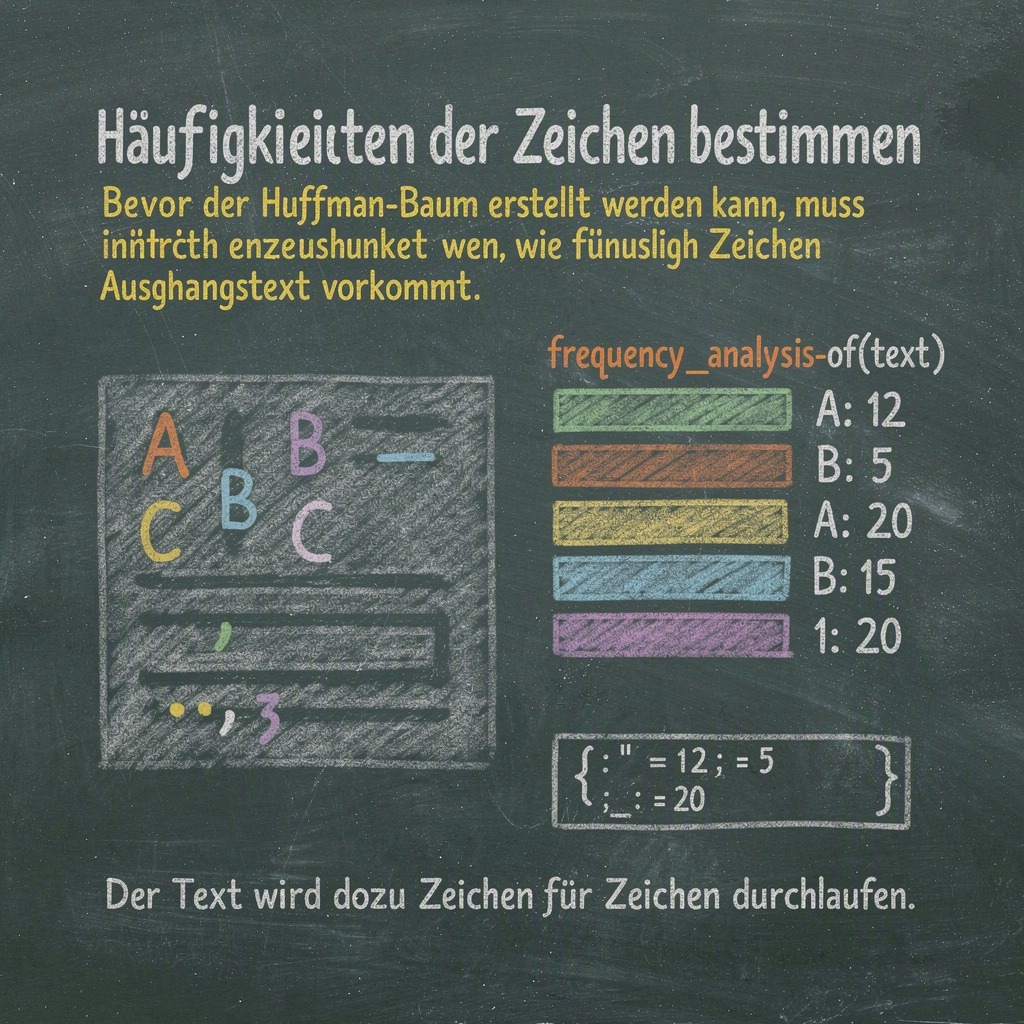
Bevor der Huffman-Baum erstellt werden kann, muss zunächst untersucht werden, wie häufig jedes Zeichen im Ausgangstext vorkommt. Diese Häufigkeitsanalyse übernimmt die Funktion frequency_analysis_of(text).
Als Ergebnis liefert die Funktion ein Wörterbuch (dictionary). Darin wird jedem Zeichen seine absolute Häufigkeit zugeordnet. Der Text wird dazu Zeichen für Zeichen durchlaufen:
- Ist ein Zeichen bereits im Wörterbuch enthalten, wird sein Zähler um eins erhöht.
- Taucht ein Zeichen zum ersten Mal auf, wird es mit dem Wert
1aufgenommen. - Am Ende enthält das Wörterbuch alle im Text vorkommenden Zeichen mit ihrer jeweiligen Häufigkeit.
def frequency_analysis_of(text):
    frequencies = {}
    for char in text:
        if char in frequencies:
            frequencies[char] += 1
        else:
            frequencies[char] = 1
    return frequencies
Die Variable frequencies speichert dabei die Häufigkeitstabelle. Durch den Aufruf der Funktion mit einem beliebigen Text kann diese Tabelle anschließend für den Aufbau des Huffman-Baums verwendet werden.
Der Huffman-Baum
Für die Erstellung des Huffman-Baums werden zunächst zwei vorbereitende Schritte durchgeführt. Anschließend folgt die eigentliche Funktion huffman_tree_from(frequencies).
1. Import der Klasse BinTree
Die Klasse BinTree wird direkt aus einem GitHub-Repository geladen. Dadurch muss keine zusätzliche Datei auf dem eigenen Rechner gespeichert werden. Für die Ausführung dieses Codes ist jedoch eine Internetverbindung erforderlich.
from urllib.request import urlopen
from types import ModuleType
import sys

url = "https://raw.githubusercontent.com/ffritzemedia/ADT_Python/main/ADT/adt.py"

adt_remote = ModuleType("adt_remote")

with urlopen(url) as antwort:
    quelltext = antwort.read().decode("utf-8")

exec(compile(quelltext, url, "exec"), adt_remote.__dict__)

sys.modules["adt_remote"] = adt_remote

BinTree = adt_remote.BinTree
2. Hilfsklasse für die Baumknoten
In den Baumknoten sollen sowohl das Zeichen als auch dessen Häufigkeit gespeichert werden. Dafür wird die Hilfsklasse item verwendet.
class item:
    def __init__(self, weight, char):
        self.weight = weight
        self.char = char

    def __lt__(self, other):
        return self.weight < other.weight
Das Attribut weight speichert das Gewicht beziehungsweise die Häufigkeit eines Zeichens. Das Attribut char enthält das zugehörige Zeichen.
Die Methode __lt__ legt fest, wie zwei Objekte der Klasse item verglichen werden. Verglichen werden ihre Gewichte. Dadurch können die Bäume später nach ihren Häufigkeiten sortiert werden.
3. Funktion zur Erstellung des Huffman-Baums
Die Funktion huffman_tree_from(frequencies) erstellt aus einem Wörterbuch mit Zeichenhäufigkeiten einen Huffman-Baum. Dabei wird das Prinzip des Huffman-Algorithmus umgesetzt: Immer die beiden Bäume mit den kleinsten Gewichten werden ausgewählt und zu einem neuen Baum zusammengefügt.
Zunächst wird die Klasse BinTree durch die Vergleichsfunktion bin_tree_lt erweitert. Dadurch können die Baumobjekte anhand des Gewichts ihres Inhalts miteinander verglichen und sortiert werden:
def bin_tree_lt(self, other):
    return self.getItem() < other.getItem()

BinTree.__lt__ = bin_tree_lt
Anschließend wird für jedes Zeichen aus dem Wörterbuch ein eigener Baum mit einem Inhalt der Klasse item erzeugt. In diesem Inhalt werden das Zeichen und seine Häufigkeit gespeichert:
trees = []

for char, weight in frequencies.items():
    tree = BinTree(item(weight, char))
    trees.append(tree)
Die entstandenen Bäume werden nach ihrem Gewicht sortiert. Solange mehr als ein Baum vorhanden ist, werden die beiden Bäume mit den kleinsten Gewichten entnommen:
trees = sorted(trees)

while len(trees) > 1:
    left = trees.pop(0)
    right = trees.pop(0)
Aus diesen beiden Bäumen entsteht ein neuer gemeinsamer Baum. Sein Gewicht ist die Summe der beiden Einzelgewichte. Da der neue Knoten keinem einzelnen Zeichen entspricht, wird sein Zeichen mit None angegeben:
merge = BinTree(
    item(left.getItem().weight + right.getItem().weight, None),
    left,
    right
)
Der neue Baum wird wieder in die Liste eingefügt. Danach wird die Liste erneut sortiert, damit im nächsten Durchlauf wieder die beiden Bäume mit den kleinsten Gewichten ausgewählt werden können:
trees.append(merge)
trees = sorted(trees)
Dieser Vorgang wird wiederholt, bis nur noch ein einziger Baum übrig bleibt. Dieser Baum ist der vollständige Huffman-Baum und wird am Ende zurückgegeben:
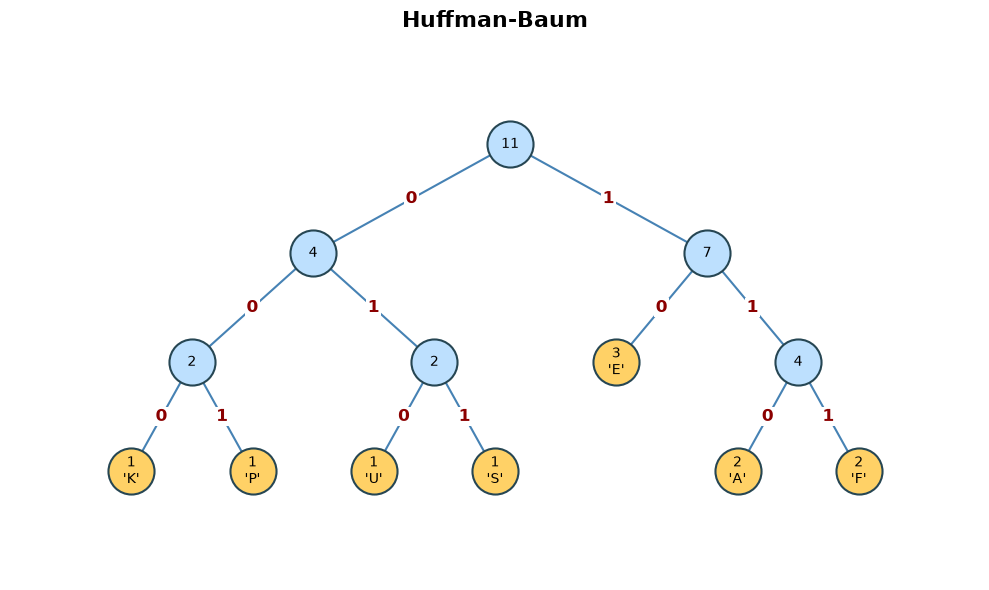
return trees.pop(0)Die Gewichtssumme des Wurzelknotens entspricht dabei der Gesamtzahl aller Zeichen des untersuchten Textes. Die Blätter enthalten die einzelnen Zeichen, während die inneren Knoten lediglich die zusammengefassten Gewichtssummen speichern.
Abschluss
Damit ist der Weg von der Häufigkeitsanalyse über den Aufbau des Huffman-Baums bis hin zur Codierung und Decodierung eines Textes vollständig nachvollziehbar. Das Notebook bietet die Möglichkeit, die einzelnen Schritte selbst auszuprobieren und das Prinzip der verlustfreien Datenkompression praktisch zu erkunden. Viel Erfolg beim Experimentieren mit dem Huffman-Algorithmus!
Schreibe einen Kommentar zu