

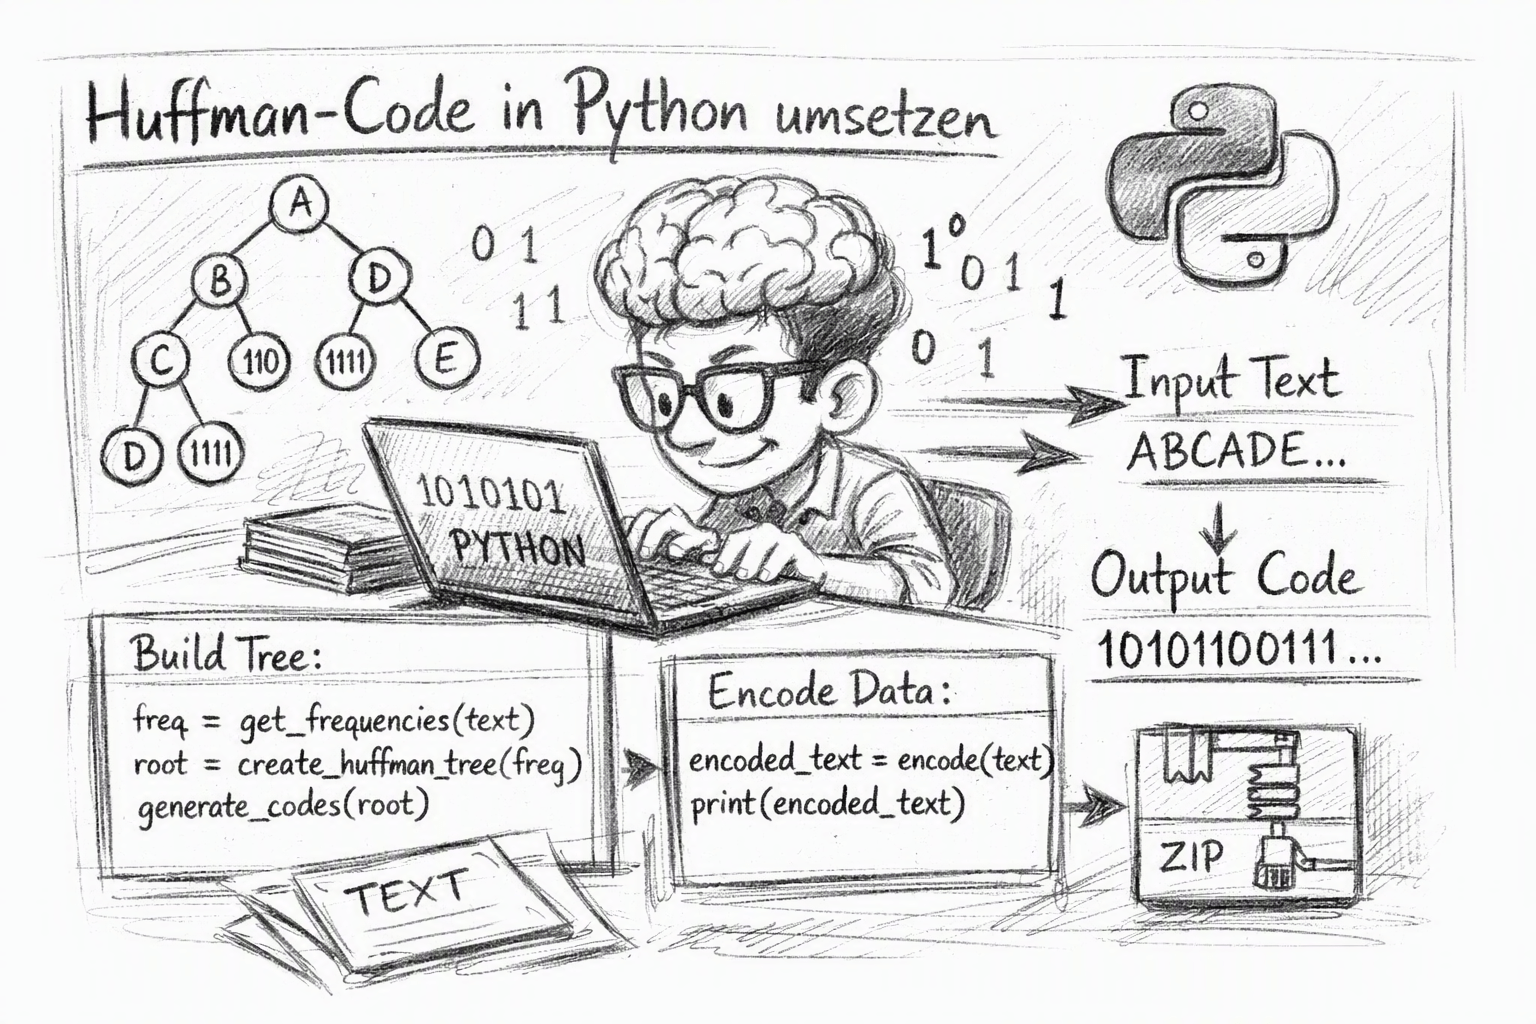
Im ersten Teil wurde am Beispiel von KAFFEEPAUSE gezeigt, wie der Huffman-Algorithmus anhand von Zeichenhäufigkeiten einen Binärbaum erstellt und daraus platzsparende, eindeutige Codes gewinnt. Die Grundlagen werden in Teil 1 auf ffritze.de ausführlich erklärt.
In diesem zweiten Teil wird der Huffman-Algorithmus in Python implementiert und in einem Jupyter Notebook schrittweise nachvollzogen. Dabei steht nicht nur das fertige Programm im Mittelpunkt. Die einzelnen Datenstrukturen und Verarbeitungsschritte werden sichtbar gemacht, sodass der Aufbau des Huffman-Baums und die Erzeugung der Codes direkt ausprobiert werden können.
(mehr …)