

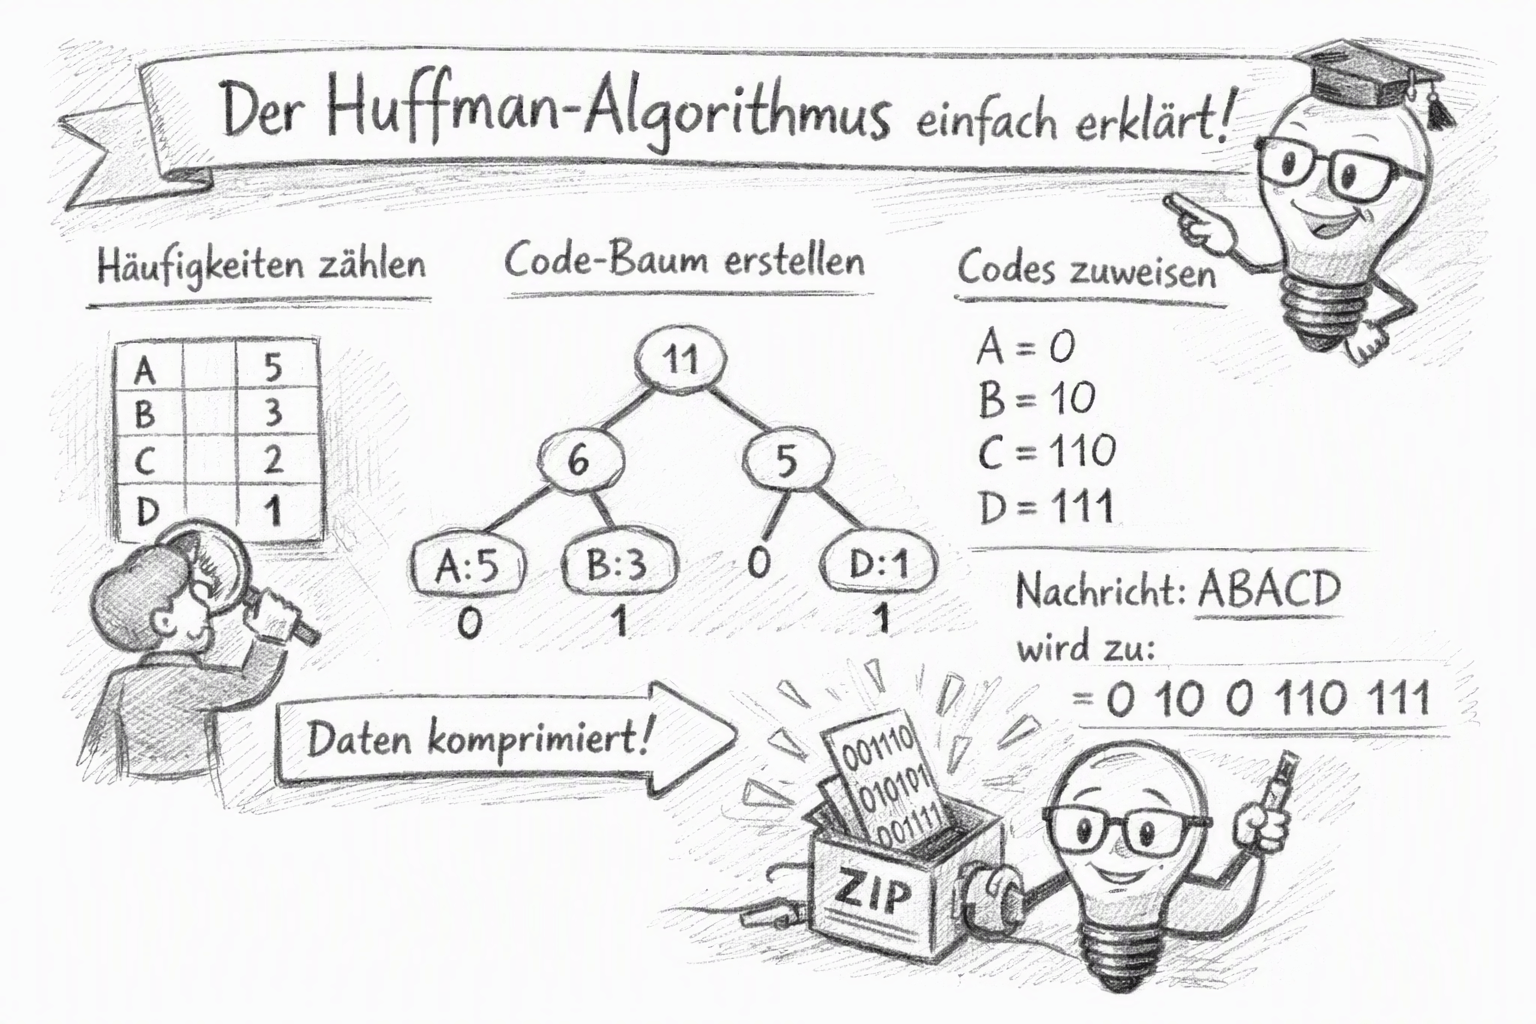
Herkömmliche Computercodes geben jedem Buchstaben starr denselben Speicherplatz – das häufige ‚E‘ verbraucht genauso viel wie das seltene ‚K‘.
Der Huffman-Algorithmus wählt einen clevereren Weg: Häufige Zeichen bekommen sehr kurze Codes, seltene etwas längere. So schrumpft die Datenmenge ohne jeden Informationsverlust.
Wie aus Zeichenhäufigkeiten Schritt für Schritt ein eleganter Huffman-Baum entsteht, schauen wir uns direkt am Beispielwort an: KAFFEEPAUSE.
Der klassische Ansatz: Der Blockcode (Festlängencode)
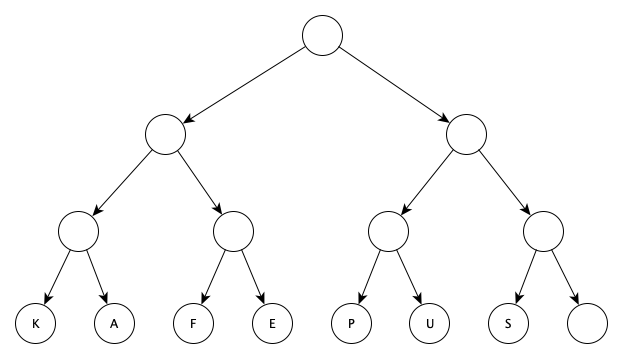
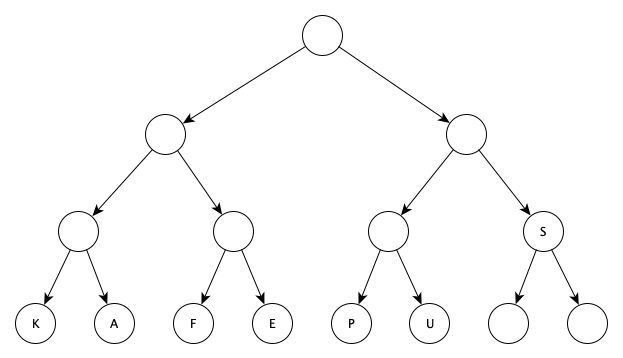
Beim herkömmlichen Blockcode bekommt jedes Zeichen einen gleich langen Binärcode zugewiesen. Die Erstellung lässt sich wunderbar als gleichmäßiger Entscheidungsbaum darstellen:
- Zeichen zählen: Das Wort KAFFEEPAUSE besteht aus 11 Buchstaben, verwendet aber nur 7 verschiedene Zeichen (
K,A,F,E,P,U,S). - Bits festlegen: Um 7 verschiedene Zeichen eindeutig zu unterscheiden, brauchen wir einen 3-Bit-Code (2^3 = 8 Kombinationen). In der Grafik entspricht das einem Baum mit genau 3 Ebenen.
- Pfade zuweisen: Jede Verzweigung nach links steht für eine
0, nach rechts für eine1. Jeder Buchstabe liegt am Ende eines genau 3 Schritte langen Pfades.
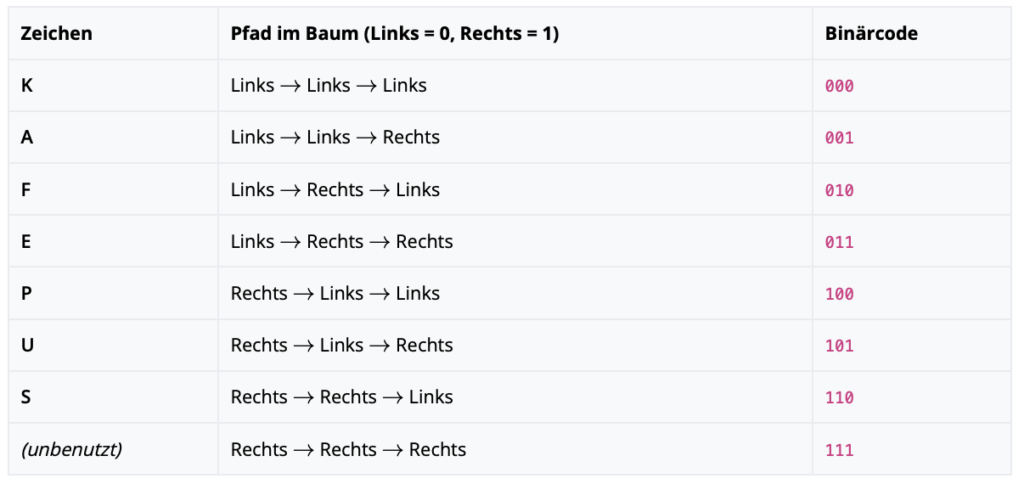
Codetabelle (Blockcode)
Da der Baum genau 3 Ebenen tief ist, erhält jedes Zeichen einen 3-Bit-Code:
Der codierte Text für KAFFEEPAUSE
Buchstabe für Buchstabe übersetzt:
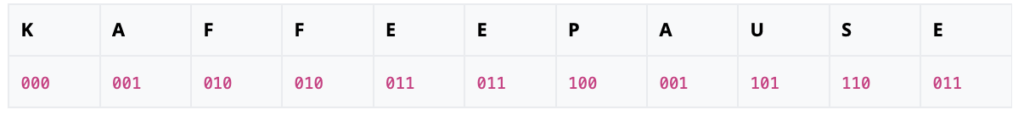
Gesamter Binärcode:000001010010011011100001101110011
Länge: 11 Buchstaben ⋅ 3 Bits = 33 Bits
Das Problem dabei:
Obwohl das E dreimal vorkommt und K nur einmal, verbrauchen beide exakt 3 Bits. Zudem bleibt die achte Kombination (der leere Kreis ganz rechts unten) völlig ungenutzt.
Manche Codes dürfen kürzer sein: Der Flexcode
Beim Blockcode haben alle Zeichen drei Stellen. Das ist zwar übersichtlich, aber nicht zwingend nötig: Sobald der Pfad 11 erreicht ist, wissen wir bereits, dass nur noch das Zeichen ‚S‘ gemeint sein kann. Die zusätzliche Verzweigung wäre also überflüssig.
Deshalb kann das ‚S‘ im Codebaum eine Ebene nach oben rücken und erhält den kürzeren Code 11. Die übrigen Zeichen behalten ihre dreistelligen Codes. So entsteht ein Flexcode: Die Codewörter dürfen unterschiedlich lang sein, bleiben aber eindeutig entschlüsselbar, sofern kein Buchstabe weiter unten in dem Baum steht als ein anderer.
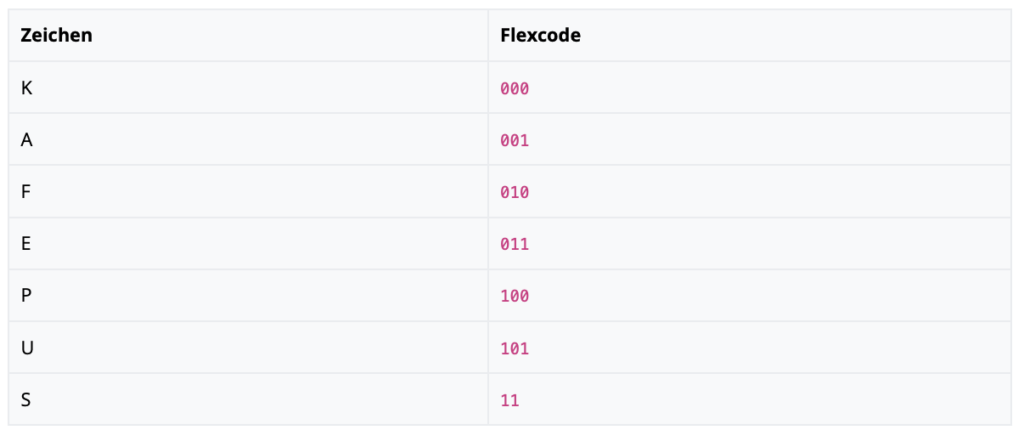
Für KAFFEEPAUSE ergibt sich damit:
00000101001001101110000110111011
Der Flexcode benötigt nun 32 Bits statt 33 Bits beim Blockcode. Das ist nur ein kleiner Unterschied – aber das Prinzip ist entscheidend: Nicht jedes Zeichen muss gleich viel Platz bekommen.
Warum brauchen wir den Huffman-Algorithmus?
Beim Flexcode haben wir bereits gesehen: Codes dürfen unterschiedlich lang sein. Um noch mehr Speicherplatz zu sparen, wäre es bei unserem Beispiel sinnvoll, das häufig vorkommende ‚E‘ weiter im Baum nach oben zu verschieben. Schließlich erscheint es dreimal im Wort, während etwa ‚K‘, ‚P‘, ‚U‘ und ‚S‚ nur jeweils einmal vorkommen.
Bei nur sieben Zeichen lässt sich noch gut überlegen, welche Anordnung besonders günstig sein könnte. Bei längeren Texten mit vielen unterschiedlichen Zeichen wird das jedoch schnell unübersichtlich. Es gibt dann sehr viele mögliche Codebäume – alle Varianten auszuprobieren und miteinander zu vergleichen, würde viel zu lange dauern.
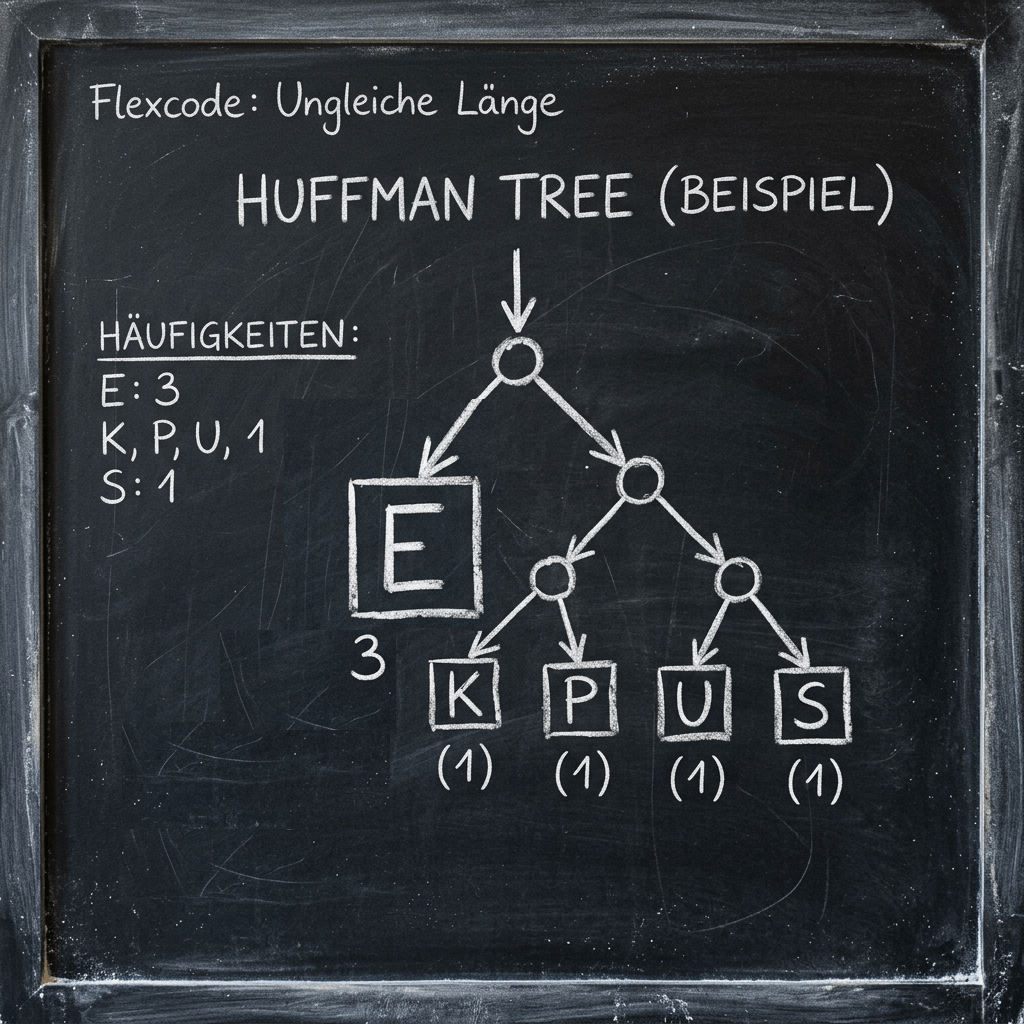
Genau hier hilft der Huffman-Algorithmus: Er erstellt aus den Häufigkeiten der Zeichen systematisch einen möglichst platzsparenden, eindeutig lesbaren Codebaum. Häufige Zeichen landen dabei möglichst weit oben im Baum und erhalten kurze Codes; seltene Zeichen bekommen längere Codes.
Häufigkeitsanalyse
Für das Wort ‚KAFFEEPAUSE‘ wird zunächst ermittelt, wie häufig jeder Buchstabe vorkommt: ‚E‘ erscheint dreimal, ‚A‘ und ‚F‘ jeweils zweimal, ‚K‚, ‚P‘, ‚U‘ und ‚S‘ jeweils einmal. Diese Häufigkeiten bilden die Grundlage für den Huffman-Baum.
Erklärung des Verfahrens
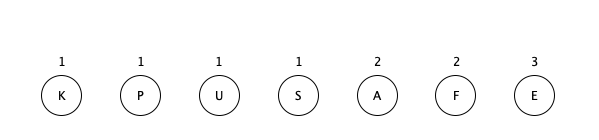
Zuerst werden die Knoten entsprechend ihrer Häufigkeit beziehungsweise ihres Gewichts angeordnet.
Im nächsten Schritt werden immer die beiden Knoten mit den kleinsten Häufigkeiten ausgewählt und zu einem neuen Knoten verbunden. Die Häufigkeiten der beiden Knoten werden addiert. Zunächst werden beispielsweise K und Pzusammengefasst:
1+1=2
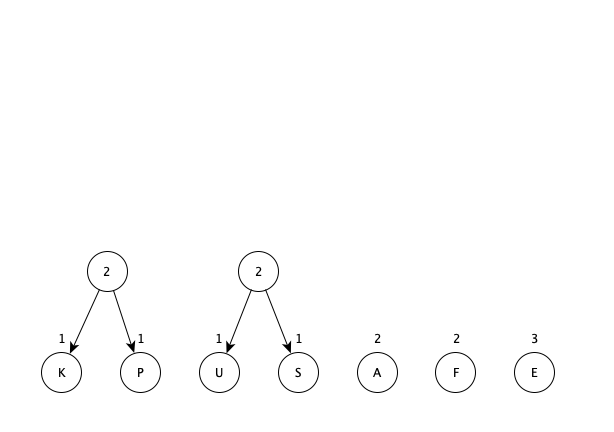
Aus den beiden einzelnen Knoten entsteht also ein neuer Knoten mit der Häufigkeit 2.
Anschließend werden die beiden noch verbliebenen Zeichen mit der Häufigkeit 1, also U und S, verbunden:
1+1=2
Nun gibt es keine einzelnen Knoten mit der Häufigkeit 1 mehr. Übrig sind vier Knoten mit der Häufigkeit 2 – die Teilbäume KP, US sowie die einzelnen Zeichen A und F – und der Knoten E mit der Häufigkeit 3.
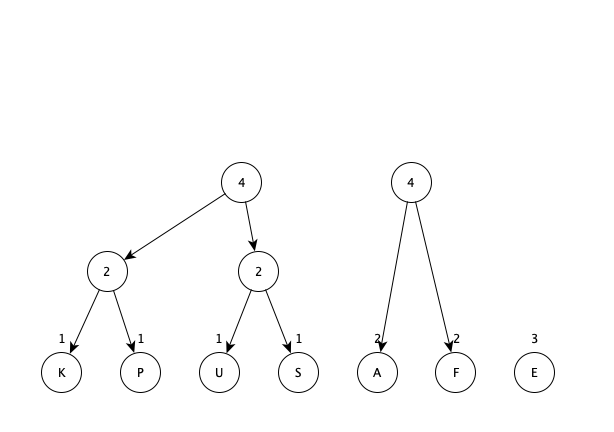
Jetzt werden wieder die beiden kleinsten Knoten ausgewählt. Die Teilbäume KP und US werden verbunden:
2+2=4
Damit entsteht ein größerer Teilbaum mit der Häufigkeit 4. Danach werden A und F zusammengefasst:
2+2=4
Es liegen nun die Häufigkeiten 3, 4 und 4 vor. Die beiden kleinsten Knoten sind E mit 3 sowie einer der beiden 4er-Knoten. In der gezeigten Konstruktion werden E und der Teilbaum AF verbunden:
3+4=7
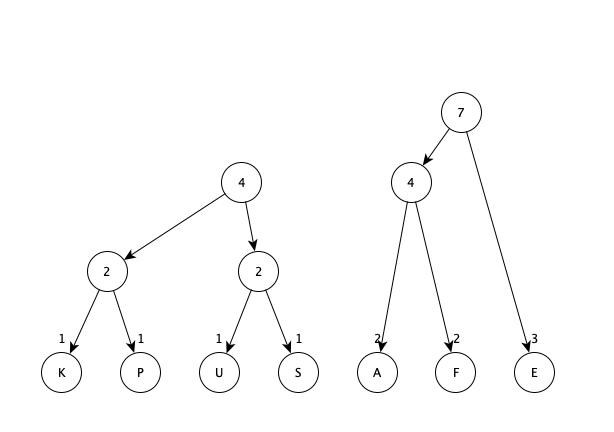
Zum Schluss werden die beiden verbleibenden Teilbäume mit den Häufigkeiten 4 und 7 zusammengeführt:
4+7=11
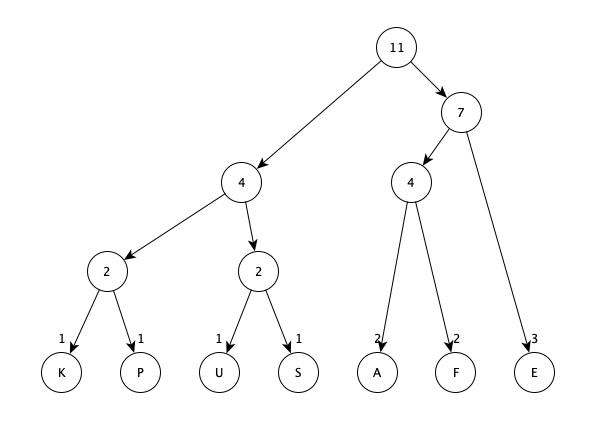
Damit ist der Huffman-Baum vollständig. Die Zahl 11 an der Wurzel entspricht der Gesamtzahl aller Zeichen im Wort.
Wie daraus die Codes entstehen
Anschließend wird jeder Kante des Baums eine binäre Ziffer zugeordnet, zum Beispiel links die 0 und rechts die 1. Der Code eines Zeichens ergibt sich aus dem Weg von der Wurzel bis zu seinem Blatt.
Häufige Zeichen liegen dabei möglichst weit oben im Baum und erhalten kurze Codes. Seltene Zeichen liegen weiter unten und erhalten längere Codes. Für das gezeigte Beispiel bedeutet das: E mit der Häufigkeit 3 erhält einen kürzeren Code als die nur einmal vorkommenden Zeichen K, P, U und S.
Bei gleichen Häufigkeiten gibt es mehrere gleichwertige Möglichkeiten, welche Knoten miteinander verbunden werden. Deshalb können unterschiedliche Huffman-Bäume entstehen. Entscheidend ist, dass in jedem Schritt die beiden Knoten mit den kleinsten Häufigkeiten zusammengefasst werden.
Codetafel für „KAFFEEPAUSE“
Aus dem Huffman-Baum werden die Codes abgelesen: Der Weg von der Wurzel zu einem Zeichen entspricht seinem Code. Dabei wird jede Kante mit einer 0 oder 1 beschriftet.
Beispiel für E:
Die Codes der einzelnen Zeichen können je nach Beschriftung der Äste unterschiedlich aussehen.
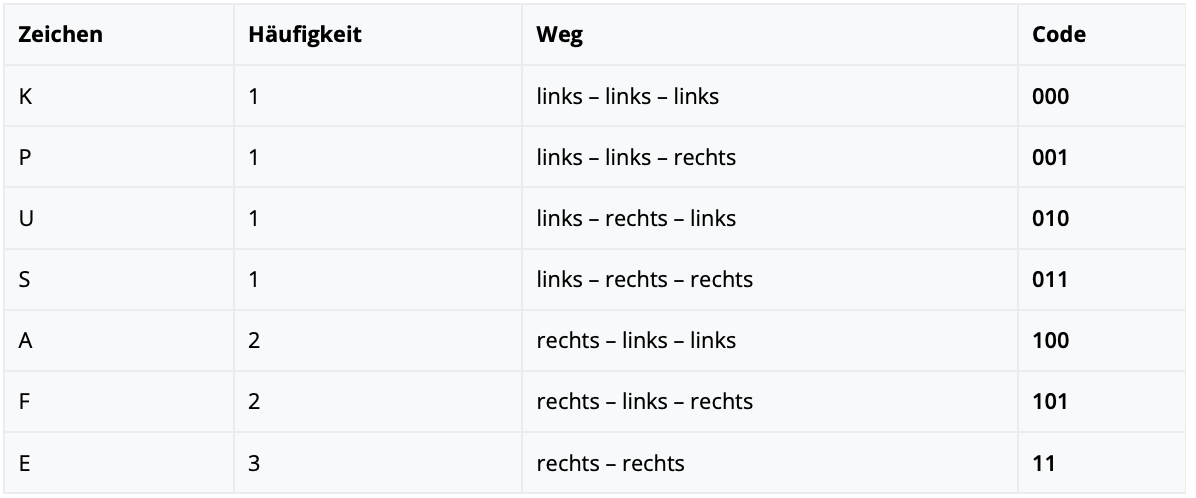
Wichtig ist, dass jeder Weg eindeutig ist und häufige Zeichen möglichst kurze Codes erhalten.
Mit Codetafel wird das Wort KAFFEEPAUSE so codiert:
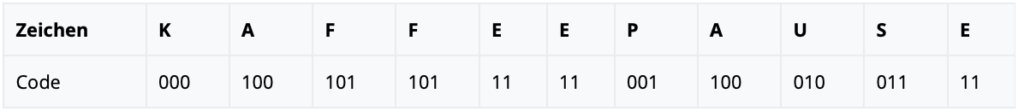
Die vollständige Bitfolge lautet:
Ohne Trennzeichen ergibt sich:
Zur Kontrolle: Die einzelnen Codes müssen beim Decodieren anhand des Huffman-Baums gelesen werden, da die Codewörter unterschiedlich lang sind.
Abschließendes Fazit
Der Huffman-Algorithmus zeigt, wie sich Daten durch eine geschickte Anordnung unterschiedlich langer Codes platzsparend darstellen lassen.
Häufig vorkommende Zeichen wie E erhalten kurze Codes, während seltene Zeichen längere Codes bekommen. Für das Wort KAFFEEPAUSE wird aus den ermittelten Häufigkeiten Schritt für Schritt ein Huffman-Baum aufgebaut.
Liest man anschließend den Weg von der Wurzel zu jedem Zeichen ab, entsteht für jedes Zeichen ein eindeutiger Code. Auf diese Weise kann das Wort ohne Informationsverlust codiert und später wieder decodiert werden. Der Huffman-Algorithmus verbindet also Häufigkeitsanalyse, Baumstruktur und effiziente Datenkompression.
Schreibe einen Kommentar zu